


 مدیر فنی
خرید سرور هوش مصنوعی HPE؛ معرفی DL380a Gen11 و DL380a Gen12
با رشد مدلهای زبانی بزرگ، بینایی ماشین و تحلیل داده، بسیاری از سازمانهای ایرانی به دنبال خرید سرور هوش مصنوعی برای راهاندازی زیرساخت در محل (On-Premise) هستند؛ چه به دلیل محرمانگی داده، چه محدودیت دسترسی به سرویسهای ابری خارجی. سرورهای همهمنظوره معمولاً فقط یک تا سه GPU را پشتیبانی میکنند؛ اما HPE ProLiant DL380a که حرف «a» در نامش به معنی Accelerator است، از ابتدا برای میزبانی چند GPU دوعرض طراحی شده است. در این مقاله دو نسل DL380a Gen11 و DL380a Gen12 را معرفی میکنیم، آنها را با گزینههای دیگر HPE مقایسه میکنیم و نکات کلیدی قبل از استعلام قیمت سرور هوش مصنوعی را مرور میکنیم.
سرور هوش مصنوعی چه تفاوتی با سرور معمولی دارد؟
یک سرور هوش مصنوعی در اصل سروری است که برای تغذیهی چند GPU پرمصرف طراحی شده است. سه تفاوت کلیدی دارد:
- چگالی GPU: جای فیزیکی، ریزر و خطوط PCIe کافی برای چهار تا هشت کارت دوعرض.
- توان و سرمایش: پاورهای پرتوان (معمولاً چند پاور 1800W تا 2200W) و فنهای قوی که هوای کافی را از روی GPUهای پسیو عبور میدهند.
- توازن پردازنده، حافظه و ذخیرهسازی: پردازنده و رم کافی برای آمادهسازی داده و NVMe سریع برای بارگذاری مدل و دیتاست.
HPE ProLiant DL380a Gen11
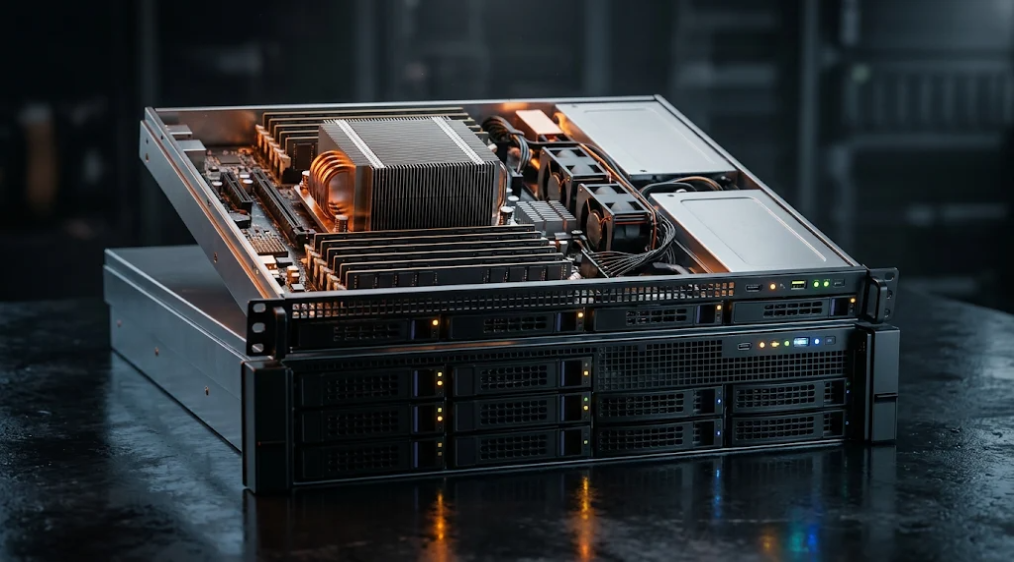
DL380a Gen11 یک سرور رکمونت 4U با دو پردازندهی Intel Xeon Scalable نسل ۴ یا ۵ است که تا ۴ کارت GPU دوعرض مانند NVIDIA L40S یا H100 را پشتیبانی میکند. GPUها در بخش جلویی شاسی قرار گرفتهاند تا هوای خنک مستقیم به آنها برسد. حافظهی DDR5، گذرگاه PCIe 5.0 و مدیریت از طریق iLO 6 از ویژگیهای این نسل است. DL380a Gen11 برای استنتاج مدلهای متوسط، فاینتیون، بینایی ماشین و رندر انتخابی متعادل است و نسبت به نسل ۱۲، در بازار گزینههای اقتصادیتری دارد.
HPE ProLiant Compute DL380a Gen12
DL380a Gen12 با پردازندههای Intel Xeon 6، حافظهی DDR5 تا ۶۴۰۰ مگاترنسفر و مدیریت iLO 7 عرضه شده است. مهمترین تغییر، ظرفیت GPU است: این سرور تا ۸ GPU دوعرض از جمله NVIDIA H200 NVL، H100 NVL، L40S و RTX PRO 6000 Blackwell Server Edition را پشتیبانی میکند و برای اتصال پرسرعت کارتها از پل NVLink در کارتهای NVL بهره میبرد. این نسل برای اجرای مدلهای زبانی بزرگ، آموزش مدلهای اختصاصی و سرویسدهی همزمان به کاربران زیاد طراحی شده است. امنیت iLO 7 را در مقالهی امنیت HPE iLO 7 در نسل ۱۲ توضیح دادهایم.
مقایسه DL380a Gen11 و DL380a Gen12
| ویژگی | DL380a Gen11 | DL380a Gen12 |
|---|---|---|
| فرم فاکتور | 4U، دو سوکت | 4U، دو سوکت |
| پردازنده | Xeon Scalable نسل ۴ و ۵ | Intel Xeon 6 |
| حافظه | DDR5 تا 5600 | DDR5 تا 6400 |
| حداکثر GPU دوعرض | ۴ کارت | ۸ کارت |
| GPUهای رایج | L40S، H100، L4 | H200 NVL، H100 NVL، L40S، RTX PRO 6000 |
| مدیریت | iLO 6 | iLO 7 با Secure Enclave |
| مناسب برای | استنتاج و فاینتیون با بودجهی متعادل | LLMهای بزرگ، آموزش و سرویسدهی گسترده |
برای تفاوتهای کلی دو نسل، مقالهی مقایسه سرورهای HPE Gen12 و Gen11 را ببینید.
گزینههای دیگر HPE برای سرور GPU
همهی پروژهها به هشت GPU نیاز ندارند. بسته به مقیاس، این گزینهها را هم در نظر بگیرید:
| سرور | ظرفیت GPU | سناریوی مناسب |
|---|---|---|
| DL380 Gen12 | تا ۳ GPU دوعرض یا ۸ GPU تکعرض | استنتاج سازمانی در کنار مجازیسازی و دیتابیس |
| DL325 و DL345 Gen12 نسخهی GPU | چند GPU در سرور تکسوکت AMD EPYC | پروژههای کوچک و متوسط با هزینهی کمتر |
| DL380a Gen11 / Gen12 | ۴ / ۸ GPU دوعرض | هوش مصنوعی مولد و LLM |
| DL384 Gen12 | سوپرچیپ NVIDIA GH200 | استنتاج و آموزش سنگین با حافظهی یکپارچه |
در فروشگاه میتوانید DL325 Gen12 GPU، DL345 Gen12 GPU، DL380a Gen12 8DW و DL384 Gen12 GH200 را ببینید.
انتخاب GPU برای سرور هوش مصنوعی
- NVIDIA L4: کممصرف (۷۲ وات) و ۲۴ گیگابایت حافظه؛ مناسب استنتاج مدلهای کوچک و پردازش ویدیو.
- NVIDIA L40S: ۴۸ گیگابایت حافظه؛ تعادل خوب بین استنتاج، فاینتیون و گرافیک.
- RTX PRO 6000 Blackwell Server Edition: ۹۶ گیگابایت حافظهی GDDR7؛ مناسب مدلهای بزرگتر در استنتاج.
- H100 NVL و H200 NVL: ۹۴ و ۱۴۱ گیگابایت حافظهی HBM؛ برای آموزش و مدلهای زبانی بزرگ.
مقایسهی کامل کارتها در راهنمای خرید کارت گرافیک سرور برای هوش مصنوعی و مقایسه H200، H100 و B200 آمده است. اگر هدف اجرای LLM داخلی است، کانفیگهای پیشنهادی را در سرور هوش مصنوعی برای اجرای مدلهای زبانی بهصورت محلی ببینید.
چکلیست خرید سرور هوش مصنوعی
- بار کاری را تعریف کنید: استنتاج، فاینتیون یا آموزش؟ اندازهی مدل و تعداد کاربران همزمان چقدر است؟
- حافظهی کل GPU را محاسبه کنید: مجموع VRAM باید مدل، کش زمینه و حاشیهی رشد را پوشش دهد.
- برای رشد برنامهریزی کنید: شروع با دو یا چهار GPU در سروری که ظرفیت هشت GPU دارد، ارتقای بعدی را ساده میکند.
- برق و سرمایش را بسنجید: یک DL380a پر از GPU چندین کیلووات مصرف دارد؛ راهنمای پاورها در پاور سرور HPE نسل ۱۱ و ۱۲ است و برای چگالی بالا خنکسازی مستقیم مایع در Gen12 را بررسی کنید.
- ذخیرهسازی و شبکه: NVMe سریع برای دیتاست و شبکهی ۲۵ یا ۱۰۰ گیگ برای انتقال داده بین سرورها.
- گارانتی و پشتیبانی: برای سرمایهگذاری سنگین، پوشش گارانتی را جدی بگیرید؛ گزینهها در گارانتی Care Pack سرورهای Gen11 و Gen12 آمده است.
اشتباهات رایج
- خرید سرور همهمنظوره و اضافهکردن GPU بعدی بدون بررسی ریزر و پاور؛ نتیجه معمولاً سقف یک یا دو کارت است.
- انتخاب GPU فقط بر اساس قیمت بدون توجه به ظرفیت حافظه.
- نادیدهگرفتن زیرساخت اتاق سرور؛ برق تکفاز ضعیف یا سرمایش ناکافی کارایی GPU را محدود میکند.
- بیتوجهی به نرمافزار: برنامهی استقرار مدل (vLLM، Triton، Ollama و…) و لایسنسها را پیش از خرید مشخص کنید.
قیمت سرور هوش مصنوعی به چه عواملی بستگی دارد؟
بیشترین سهم قیمت سرور هوش مصنوعی را GPUها تشکیل میدهند؛ پس تعداد و مدل کارتها تعیینکنندهی اصلی است. پس از آن، پردازنده، مقدار رم، ذخیرهسازی NVMe، پاورها و گارانتی اثر دارند. چون قیمت این تجهیزات به نرخ ارز و موجودی وابسته است، در این مقاله عدد ذکر نمیکنیم؛ قیمت روز هر کانفیگ در صفحهی محصول در فروشگاه ایران اینفرا بهروزرسانی میشود و کارشناسان ما میتوانند چند کانفیگ با بودجههای مختلف پیشنهاد دهند.
سوالات متداول
DL380a بهتر است یا DL380 با GPU؟
اگر به بیش از دو یا سه GPU دوعرض نیاز دارید یا برنامهی رشد دارید، DL380a انتخاب درستتری است. برای یک یا دو GPU در کنار بارهای دیگر، DL380 Gen11 یا Gen12 کافی و اقتصادیتر است.
آیا میتوان DL380a را با دو GPU خرید و بعداً ارتقا داد؟
بله، یکی از مزیتهای DL380a همین است؛ فقط پاورها، ریزرها و کیت کابل را از ابتدا متناسب با ظرفیت نهایی انتخاب کنید.
برای اجرای مدلهای زبانی ۷۰ میلیارد پارامتری چه کانفیگی لازم است؟
بسته به کوانتیزهسازی، معمولاً به مجموع حافظهی GPU حدود ۸۰ تا ۱۶۰ گیگابایت نیاز است؛ مثلاً یک H200 NVL یا دو کارت L40S یا H100 NVL. جزئیات در مقالهی LLM محلی آمده است.
سرور هوش مصنوعی به برق سهفاز نیاز دارد؟
نه لزوماً، اما مصرف چند کیلوواتی یک سرور پر از GPU باید با PDU، فیوز و UPS مناسب تأمین شود. پیش از خرید، ظرفیت برق رک را بسنجید.
جمعبندی و استعلام قیمت
HPE ProLiant DL380a Gen11 برای پروژههای استنتاج و فاینتیون با بودجهی متعادل و DL380a Gen12 برای مدلهای زبانی بزرگ و سرویسدهی گسترده، دو انتخاب اصلی برای خرید سرور هوش مصنوعی هستند. ایران اینفرا مجموعهی کاملی از سرورهای GPU و هوش مصنوعی و کارتهای گرافیک سرور را تستشده و با گارانتی عرضه میکند. برای استعلام قیمت و دریافت کانفیگ پیشنهادی بر اساس مدل و تعداد کاربرانتان، با کارشناسان ما تماس بگیرید.
نظرات کاربران